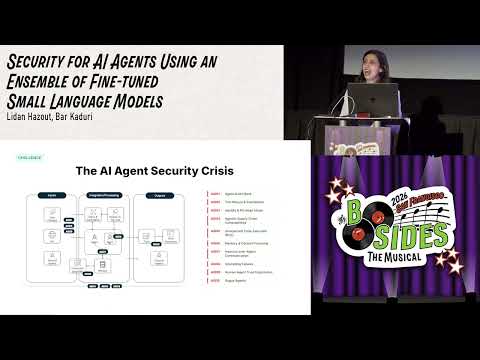
Security for AI Agents Using an Ensemble of Fine-tuned... (Lidan Hazout, Bar Kaduri)
summary
Runtime guardrail intercepts agent tool calls pre-invocation interception and runs an ensemble of fine-tuned SLMs (4–12B) in parallel — instruction‑violation, data‑security, and threat‑detection judges — using LoRA fine‑tuning on public and synthetic data with top‑3 LLM quorum labeling and human validation. Decisions use a RAG memory for org‑specific patterns, auto‑deny at 95% certainty and auto‑approve below 50%, yields near‑100% F1 on tuned Mistral and sub‑second to second latency.
AI-written summary · about
chapters (17)
- 0:00Introduction and speaker intro
- 1:51Why AI agent security matters
- 3:38OWASP AI Security Top 10 risks
- 6:10Agent goal hijack explained
- 6:52Rogue agent risks
- 8:17Security gate concept
- 10:04Architecture overview
- 13:39Why small language models
- 15:04Security judges breakdown
- 17:11Memory system and RAG
- 19:14Training small language models
- 21:22Model performance results
- 23:10Runtime decision process
- 24:55Scalability and microservices
- 26:00Innovation highlights
- 27:03Summary and future outlook
- 28:10Q&A session begins
related talks
 35mMulti-Layered Guardrails for Cloud Native AI: Enforcin...
 17mGuardrails First: Designing AI Agents for Security Operations
 39mBuilding Safe AI Agents
 26mOne guardrail is not enough: Defense-in-depth against LLM jailbreaks
 30mWhy Prompt-Level Guardrails Fail for AI Agents
 46mAutomated AI Security Testing Using Adversarially Fine-Tuned AI Agents
 16mAdversarial AI Agents for Web3 Security
 37mSecure by Design: Strategies for LLM Adoption in Cloud-Native Environm...