End-to-end data validation strategies in Microsoft Fabric

summary
Outlines a practical end-to-end approach for medallion-style data validation in Microsoft Fabric: three concrete checkpoints—schema validation on ingest, table/dataframe checks during transforms (using Python libraries like Great Expectations, Pandera or pydantic, or DBT for SQL), and semantic-model validation via semantic link/senpai that evaluates DAX and relationships. Shows notebooks that write per-check results into a central lakehouse for enterprise monitoring, triggers Data Activator alerts on failures, and uses Fabric certification on gold assets; all examples are implemented and runnable.
AI-written summary · about
chapters (11)
- 0:00Introduction to data validation
- 1:02Common pipeline failure points
- 11:50Three tiers of validation
- 16:26Implementing schema validation
- 17:57Tooling and data validation
- 20:23Table and dataframe validation
- 23:11Semantic model validation
- 24:53Comparison of validation tools
- 32:23Enterprise monitoring strategies
- 38:32Data governance and certification
- 39:01Conclusion and Q&A
related talks
 27mModernize your data integration to enable petabyte scale analytics with Microsoft Fabric
 37mData Validation at Scale: Managing Data Quality in Complex Data Pipelines
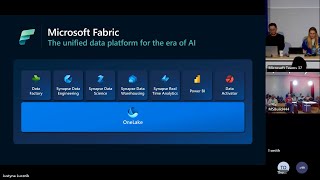 50mMicrosoft Fabric Data Factory Q&A
 31mData Reliability Engineering: Secret Of Our Success
 20mData Mesh, Data Fabric & Co - the End of Monolithic Architecture Concepts?
 15mQuick Guide on Data Quality Assurance
 20mData Mesh testing: An opinionated view of what good looks like
 49mExtend and enhance your analytics applications with Microsoft Fabric