Learning probability distributions; what can, what can't be done
summary
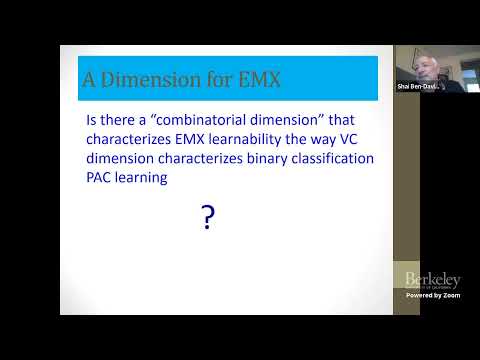
Shows that density estimation is impossible without prior knowledge: samples of size independent of domain size cannot distinguish distributions that are 0.5 apart in total variation (birthday paradox argument). Uses sample compression schemes to get nearly tight bounds for mixtures of Gaussians — sample complexity scales about k d^2 / ε^2 for k Gaussians in R^d. Proves there is no single combinatorial dimension characterizing distribution learnability and that some EMX learnability questions are independent of set theory.
AI-written summary · about
chapters (10)
- 0:00Learning probability distributions
- 1:04Density estimation needs prior knowledge
- 7:52Learning distributions with assumptions
- 13:17Mixture of Gaussians compression
- 20:36Learnable distribution families
- 28:58No quantitative dimension for learning
- 43:46No qualitative dimension for learnability
- 52:27Learning distribution properties
- 57:53EM and uniform convergence failure
- 1:08:35Learnability independence for real functions
related talks
 47mUnprovability and Other Impossibility Results in Machine Learning
 15mFundamental Limits Of Learning In Data-Driven Problems
 53mDesigning Robust Learners
 36mPrivately Learning High-Dimensional Distributions
 29mApproximating Spherical Gaussian Mixtures
 01h 28mMulti-Distribution Learning, for Robustness, Fairness, and Collaboration
 42mWhat (Doesn't) Make Learning Algorithms Generalize?
 38mLearning with Distributional Inverters